追光
@追光
1小时, 7 分钟 前在线-

追光 在版块 AI Agent与自动化 中发起了话题 AI模型背后的“硬通货”:读懂 Token 的前世今生与计费方式 4个月 前
在人工智能和大语言模型(LLM)爆火的今天,无论是开发者还是普通用户,都不可避免地遇到一个词Token(令牌/词元)。买 API 额度时,商家按“每百万 Token”开价;和 AI 聊天时,界面会提示“上下文 Token 限制”。那么,这个神秘的 Token 究竟是什么?它是怎么来的?又是如何决定你钱包里银子流向的?今天我们就来彻底扒一扒大模型背后的这套“硬通货”。
一、 Token 的由来:AI 是如何“识字”的?
要理解 Token 的由来,首先要明白一个底层逻辑:计算机本质上是个“数学脑袋”,它根本不认识人类的文字。
无论是汉字、英文单词、数字还是标点符…[查看更多]
-
这些参数是控制acestep.cpp(Turbo 模型) AI 音乐生成效果的核心“旋钮”。下面拆解这些参数的物理含义和调整建议。
一、 DIT FLOW MATCHING (DiT 扩散模型参数)
这是决定“声音质量”的引擎。
Inference Steps (推理步数)
意义:扩散模型去噪的次数。步数越多,细节越细腻,但越耗时。
Turbo 模型建议:官方预设是 8,你设为 12 是合理的,能稍微增加一点稳定性。不需要过高,否则反而可能产生噪音。Guidance Sca…[查看更多]
-
目录
- [初始设置案例](#初始设置案例)
- [日常开发工作流](#日常开发工作流)
- [消息平台集成](#消息平台集成)
- [多环境管理案例](#多环境管理案例)
- [故障排查案例](#故障排查案例)
- [高级用法案例](#高级用法案例)
初始设置案例
案例 1: 首次安装和配置
bash
# 步骤 1: 安装

curl -fsSL https://raw.githubusercontent.com/NousResearch/hermes-agent/main/scripts/install.sh | bash
# 步骤 2: 进入安装目录
cd ~/.hermes/herm…[查看更多] -
.hermes-cheatsheet { max-width: 100%; overflow: hidden; box-sizing: border-box; font-family: system-ui, -apple-system, “Segoe UI”, Roboto, sans-serif; line-height: 1.6; color: #1f2937; } .hermes-cheatsheet h2, .hermes-cheatsheet h3 { margin: 1.5em 0 0.5em; line-height: 1.25; } .hermes-cheatsheet h2 { border-bottom:…[查看更多]
-
追光 在版块 AI Agent与自动化 中发起了话题 Hermes Agent完整命令参考手册|安装配置与Agent管理 4个月, 1周 前
Hermes Agent目录
- [安装与初始化](#安装与初始化)
- [基础交互命令](#基础交互命令)
- [配置管理命令](#配置管理命令)
- [工具与技能管理](#工具与技能管理)
- [Profile 多环境管理](#profile-多环境管理)
- [网关与消息平台](#网关与消息平台)
- [诊断与维护](#诊断与维护)
- [高级选项与参数](#高级选项与参数)
安装与初始化
? 安装
bash
# 1. 交互式安装(推荐,首次使用)[查看更多]
curl -… -
追光 在版块 AI Agent与自动化 中回复了话题 【Hermes Agent】微信助手ClawBot网关配置与部署 4个月, 1周 前
macOS 推荐使用原生 launchd 实现登录自启,支持后台常驻、崩溃自动重启,且不影响终端会话。
1. 创建日志目录
mkdir -p ~/.hermes/logs2. 编写自启配置文件
cat > ~/Library/LaunchAgents/com.hermes.gateway.plist << 'EOF'Labelcom.hermes.gateway
ProgramArguments/Users/xbaby/.hermes/hermes-agent/venv/bin/hermes
gatewayWorkingDirectory/User…[查看更多]
-
追光 在版块 AI Agent与自动化 中发起了话题 【Hermes Agent】微信助手ClawBot网关配置与部署 4个月, 1周 前
无需公网服务器、无需 Webhook、支持个人微信直连。本文是 Hermes Agent 的安装、配置与启动,并结合 LLM Wiki 与 Obsidian,搭建一套可长期演进的 AI 知识沉淀工作流。适合开发者、知识工作者与 AI 爱好者实操。
一、环境准备
在开始部署前,请确保你的运行环境满足以下基础条件:一个可正常登录的个人微信账号;Python 3.8+ 运行环境;具备 pip 与终端命令行权限的 Linux / macOS / Windows(WSL)系统
htt…[查看更多]
-
追光 在版块 AI音乐与音频创作 中发起了话题 ACE-Step-CPP-UI 部署与全新引擎适配修复日志 4个月, 1周 前
ACE-Step 全栈部署与大版本架构迁移全纪录。它完整记录了我们如何将本地前端外壳,与 2026-05-16 发布的全新硬核 C++ 引擎(基于 Apple Silicon Metal 加速)完美缝合的整个历程。
可以直接复制保存这篇日志,作为日后复现或团队分享的技术文档。
ACE-Step-CPP-UI 部署与全新引擎适配通关日志
一、 环境与背景
硬件平台:Apple M1 Pro (Unified Memory 架构,支持 bfloat 与 Metal 硬件加速)。
软件堆栈:Node.js / TypeScript (Frontend & Server) + C++ GGML/Metal (Core Engine)。
引擎版本…[查看更多] -
pinokia版本的Ace step Ui在实践中的吞字问题,和无法使用添加乐器、编曲功能
目前在 Mac 的 MLX 生态中,官方及社区仅推出了 Turbo 这一款加速版模型。虽然它能8步就能出歌,但因为砍掉了语言模型(LM)的对齐逻辑,导致它有着极易“吞字、漏字”的顽疾,且在 MLX 下无法使用 Base 和 SFT 版本。不能使用 MLX 的其他版本(Base/SFT),最核心的原因并不是 Mac 硬件不支持,也不是Ace Step Ui不支持而是开源社区压根就没有做出这些格式的模型文件。
如果想在Mac上解锁 ACE-Step 1.5 的完整实力,强烈建议转向基于 GGUF 格式的 C++ 生态(如 acestep-cpp-ui):
功能全开:完美支持…[查看更多]
-
追光 在版块 AI Agent与自动化 中回复了话题 Hermes WebUI图形界面安装与自启动配置 4个月, 1周 前
这是一个用于 macOS 的 Hermes WebUI 自动化启动与守护安装脚本,用于一键配置 launchd 服务,使 WebUI 在系统登录后自动启动并保持运行。脚本首先清理旧的 launchd 配置,避免因残留任务导致冲突或重复加载,然后在用户的 LaunchAgents 目录中重新生成标准 plist 文件。该配置通过 ProgramArguments 直接调用 start.sh 脚本,避免使用 cd && 等复杂 shell 组合,从而提升 launchd 执行的稳定性与兼容性。同时脚本会自动执行 plist 语法校验,确保 XML 格式正确无误
cat < ~/install_hermes_webui.sh

#!/bin/bash
set -e…[查看更多]
-
追光 在版块 AI Agent与自动化 中发起了话题 Hermes WebUI图形界面安装与自启动配置 4个月, 1周 前
在本地或服务器环境中安装并运行 Hermes WebUI 图形界面(Hermes WebUI),用于与 Hermes / LLM Agent 进行可视化对话交互。通过该界面,用户可以在浏览器中直接与大语言模型进行实时对话,并观察 Agent 的响应过程与工具调用情况。
安装流程通常包括获取项目代码、配置运行环境以及启动本地服务三部分,确保依赖组件(如 Python、Node.js 或相关运行时)已正确安装。启动后,系统会在本地或指定服务器端口提供 Web 访问地址,用户可通过浏览器打开图形界面…[查看更多]
-
追光 在版块 AI Agent与自动化 中回复了话题 LLM深入大模型本地推理:参数全解析与底层显存带宽/GPU运作原理 4个月, 1周 前
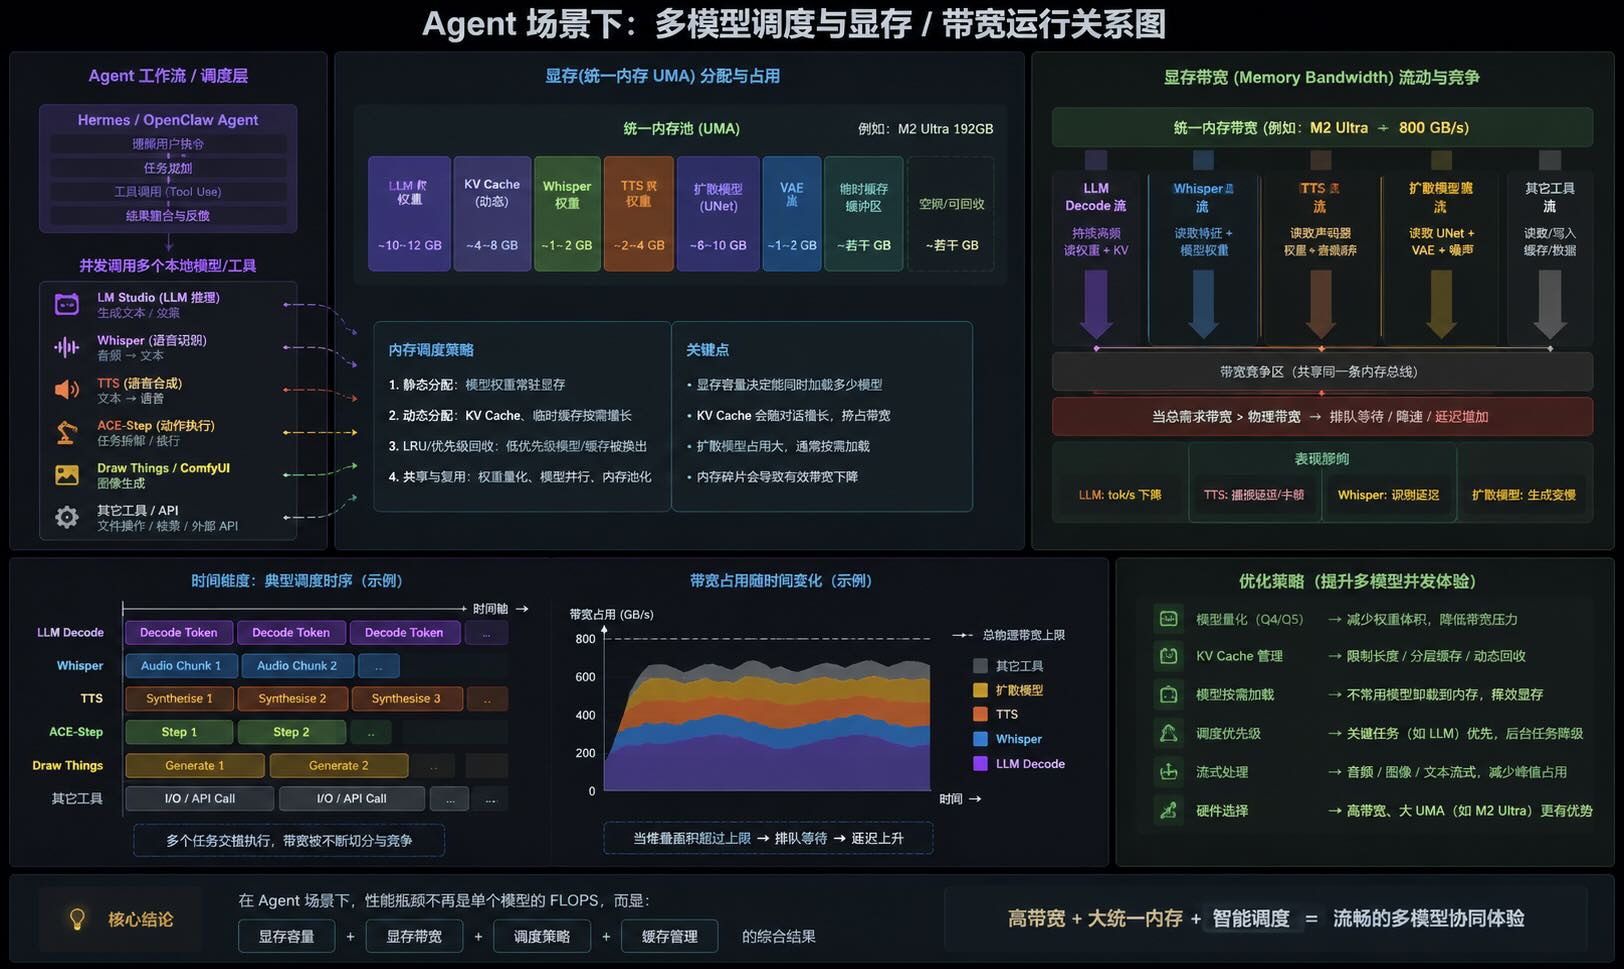
为什么 Agent 会把“显存带宽问题”无限放大
传统本地大模型通常只有:一个 LLM,一个 KV Cache,一个 Decode 循环,但在 Hermes、OpenClaw 这类 Agent 系统中,大模型已经不再只是“聊天机器人”,而更像一个 AI 调度中枢(Orchestrator)。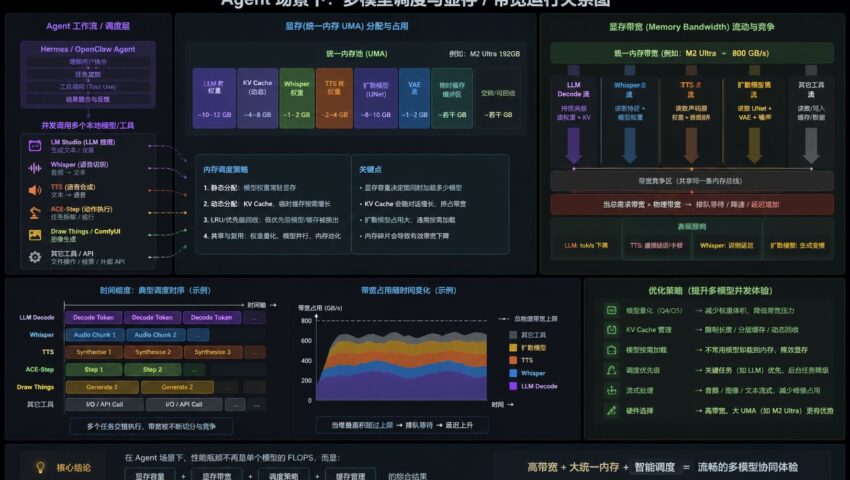
我经常使用的场景是这样的:
LM Studio:负责主 LLM 推理;Whisper:负责语音识别;TTS:负责语音合成;ACE-Step:负责音乐制作;Draw Things / ComfyUI:负责图像和视频,此时系统实际上是在同…[查看更多]
-
追光 在版块 AI Agent与自动化 中回复了话题 LLM深入大模型本地推理:参数全解析与底层显存带宽/GPU运作原理 4个月, 2周 前
✦ Apple Silicon 显存带宽对推理速度的真实影响(M1 Pro vs M2 Ultra)
以 Apple Silicon 为例,可以非常直观地理解“Decode 阶段为什么被显存带宽限制”。
在本地运行大模型时,Decoding 阶段的速度在很大程度上近似受以下关系约束:
在 Apple 的统一内存架构(UMA)下,CPU 与 GPU 共享同一块高带宽内存,因此显存带宽直接决定了模型“逐 token 读取权重”的上限。
以实际芯片为例:
* M1 Pro:统一内存带宽约
-
Hermes Agent优化首轮对话prompt方法与智能程度的方法
要优化 Hermes 的首次提交速度并解决幻觉,必须去它的用户目录(通常在 ~/.hermes/)对后台自动生成的 Markdown 文件进行物理裁剪,将前缀控制在 500字(2000字符) 以内。
一、 物理剔除不准确的“伪记忆”
Hermes 会在后台偷偷把历史对话的错误推论写进文件,导致首次开机时不仅慢,还会携带错误认知。进入目录:
cd ~/.hermes/memories/打开 MEMORY.md(事实记忆)与 USER.md(用户偏好)。
像删坏代码一样,物理整行抹去过期的环境变量、废弃的临时信息和错误的业务推论。只留下你真正要的语气和世界观(S…[查看更多]
-
LLM / Hermes Agent 首次对话延迟机制解析
在与大语言模型(LLM)或智能体(Agent,例如 Nous-Hermes)进行首次对话时,开发者和终端用户经常会遇到一种现象:
第一句回复…[查看更多] -
追光 在版块 AI Agent与自动化 中发起了话题 LLM深入大模型本地推理:参数全解析与底层显存带宽/GPU运作原理 4个月, 2周 前
在本地部署LLM本地推理(如 LM Studio、oMLX、llama.cpp…[查看更多]
-
追光 在版块 AI Agent与自动化 中回复了话题 Hermes Agent 安装与卸载与痕迹清理日志 4个月, 2周 前
gstack 与 gbrain 是专为本地模型打造的高阶 Agent 增强外挂
在 Hermes 生态中,gstack 与 gbrain 是专为本地模型打造的高阶 Agent 增强外挂:
gstack(记忆堆栈): 本地轻量化向量与知识图谱数据库,赋予模型持久的本地长文本记忆。
gbrain(认知大脑): 核心任务拆解与工具调度引擎,负责多步骤深度思考(Reasoning Loop)。三步安装与激活步骤
第一步:一键配置安装组件
打开 Mac 终端,运行 Hermes 内置的包管理器命令,自动下载依赖包:
hermes plugin install gstack gbrain第二步:编辑配置文件追加…[查看更多]
-
1. oMLX 后端:追求极限带宽与原生调度的“短跑怪兽”
oMLX 强依赖于 Apple 团队开源的 MLX 框架。它绕过了传统跨平台框架的转换损耗,直接在系统底层实现统一内存架构(UMA)的高效并行。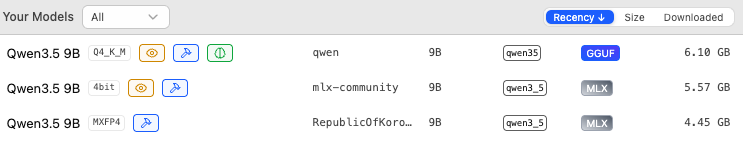
选型 A:Qwen3.5-9B-mlx-lm-mxfp4(微缩块浮点 4位量化版)
体积: 约 4.45 GB。
特点: 官方测试与跑分的“御用模特”。它采用了最前沿的 mxfp4 压缩技术,将模型分成共享缩放因子的微块,能瞬间将 M 芯片的物理带宽和硬件吞吐量塞满。
选型 B:Qwen3.5-9B-MLX-4bit(多模态/标准 4位量化版)
体积: 约 5.93 GB。
特点: 保留了完整的长文本处理逻辑与多模态视觉对齐…
-
测试本地部署的模型api是否支持视觉能力的方法
本方法利用 macOS 终端的 curl 工具,直接向本地运行的 API 接口发送一个符合 OpenAI 规范的标准多模态请求。
命令的核心亮点在于使用 Bash 动态管道符 $(base64 -i ‘图片路径’ | tr -d ‘n’)。它会在发送请求的瞬间,自动将你 Mac 本地的物理图片转换成标准的 Base64 编码字符串 嵌入到 JSON 数据中,免去了手动格式化转换的繁琐步骤。
结果判定与排查指南
运行该命令后,通过返回的 JSON 响应可瞬间判定后端的真实能力:测试通过(支持视觉): 接口成功返回 200 OK,并在 content 中输出了对该图片的结构化文本描述。…[查看更多]
-
追光 在版块 AI Agent与自动化 中回复了话题 Hermes Agent 安装与卸载与痕迹清理日志 4个月, 2周 前
Hermes 更换模型的操作:(在这里输入url,密钥,模型选择)
hermes modelCurrent model: Qwen3.5-9B-MLX-4bit
Active provider: J-MLXCustom OpenAI-compatible endpoint configuration:
API base URL [e.g. https://api.example.com/v1%5D: http://127.0.0.1:55889/v1
API key [optional]:
Verified endpoint via http://127.0.0.1:55889/v1/models (2 model(s)… - 查看更多
 京公网安备
 工信部备